Deja de creerle todo a un tipo random en Twitter (X)
Gil Gerard, un actor ochentero que protagonizaba la serie de ciencia ficción Buck Rogers en el siglo XXV, se dio cuenta del potencial que tenía explotar a una base grande de fans. Ya pasaba con las convenciones de Star Trek, y le sugirió a su colega y coprotagonista Erin Gray que lo promocionara a cambio de un 10% en convenciones de ciencia ficción.
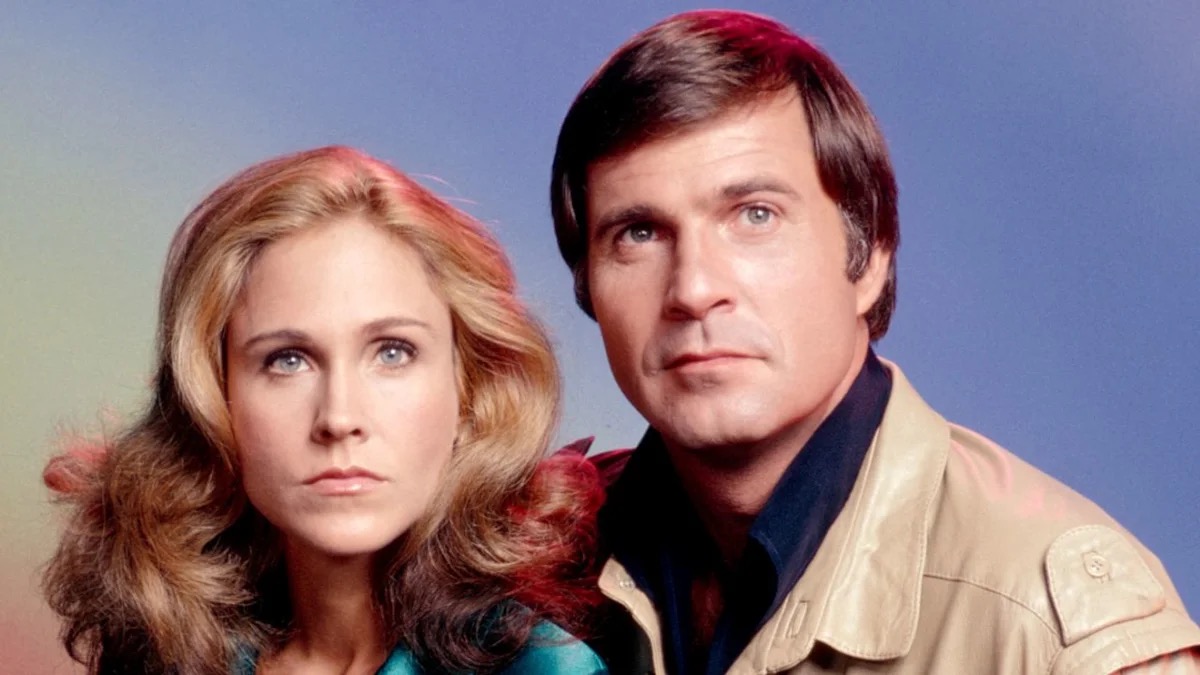
Erin Gray y Gil Gerard, Buck Rogers en el siglo XXV (1979).
Gray creó una empresa, “Heroes for Hire”, y fue muy exitosa con esto. Porque los frikis tienen dinero, y no saben cómo gastarlo a veces, y llenan convenciones disfrazados y pagan sumas exhorbitantes por una foto autografiada.
Algo pasa con los nerds, somos inteligentes para muchas cosas, pero bien limitados en otras. La suspensión del juicio es muy frecuente en el mundo tech de redes sociales. Si no, no me explico el éxito de personajes como Uncle Bob o DHH. Este último es como Gerard y Gray, pero con esteroides. Explota su base de fans para venderles su tecnología de dudosa calidad.
Hace poco en la keynote de Rails World se dedicó a pontificar sobre la programación basada en agentes. En su charla mencionó que en el último año escribi más código que en todos los años anteriores de su carrera. En un mes escribió 150,000 líneas de código, cuando su promedio era de 50,000 líneas en el año.
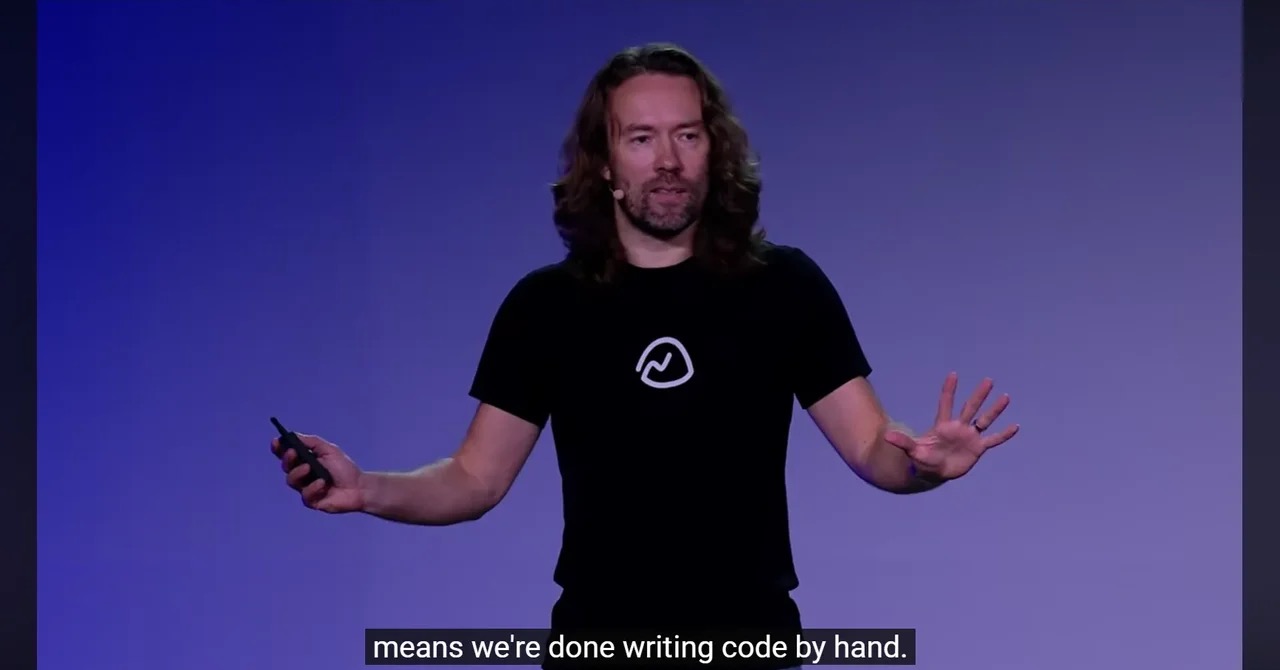
DHH en la keynote de Rails World 2026: «We’re done writing code by hand».
Esa afirmación me hizo levantar una ceja. La última vez que tuve esa sensación fue cuando abrí un libro sobre ingeniería de software, muy recomendado en redes sociales, hace unos pocos años atrás. En el prólogo el autor declaraba orgulloso haber escrito unas 250.000 líneas de código en su carrera (es un académico). No pasé de ese párrafo. ¡Qué me va a enseñar alguien que ha escrito tan poco código en su vida!
Yo también he escrito un promedio de 50.000 líneas de código al año, pero en proyectos personales, es la cifra que extraje de GitHub, por desgracia no tengo ya acceso a los repos de Uber y Cornershop de los últimos 5 años, ni tampoco a todo el código que escribí en mis primeros años profesionales en los noventa. En 2025 empecé a usar seriamente IA para programar, en ese momento me pegué el salto a 175.000 locs (de esas el 50% fue en mi actual trabajo). Este año he “generado” más de un millón de líneas de código. Increíble, ¿verdad?
Deja de creerle todo a un tipo random en Twitter (X)
La diferencia que tengo con DHH es que yo sí creo que se debe ver el código que generas con IA. No lo leo todo, obvio, no podría, pero puedo asegurar que podría entender algún fragmento al azar de ese código, porque me aseguro que se genere código entendible, mantenible y seguro.
DHH y otras “celebridades” sostienen que no hay que leer más el código, que basta con técnicas “adversariales” para inspeccionar código. Que lo más importante es generar código rápido aprovechando la velocidad con la que escribe la IA.
Yo digo que eso no es ingeniería de software. Es el equivalente en software a la seudociencia.
Por otro lado, muchos de estos personajes desarrollan un tipo muy limitado de aplicaciones o sistemas. Basecamp y los productos web de 37Signals son un pequeño subconjunto de todos los posibles sistemas que podemos programar.
Pero es que además…
Miren…
Pobre DHH. Lanza Omarchy y le encuentran montones de vulnerabilidades. Habla de cómo en 37Signals ya no ven el código, y Basecamp junto con Hey tienen una indisponibilidad grave y sus usuarios se quedan sin poder usar esos productos por un buen rato, y pasa verguenzas.
Los ingenieros de software somos unos arrogantes de mierda, y nos pasan estas cosas. Yo no voy a decir que en mi trabajo no he tenido incidentes, y que no he cometido fallos graves. Pero tengo el cuidado de admitir que eso pasa, y tengo suficientes heridas de guerra como para ser cauto en mis afirmaciones y más cauto con el código que paso a producción.
Escribir mucho código es un problema, no una ventaja
Desarrollar software más rápido no es una virtud, ni siquiera una ventaja. Es un problema, y uno grave. El código debe ser legible, no porque tú lo vas a leer, aunque sería bueno que lo leyeras. La razón es porque los LLM necesitan leerlo.
Hasta que no cambiemos el modelo de IA, necesitamos tener código fuente escrito en lenguajes de programación tradicionales. Además ese código debe ser legible por humanos y por máquinas, porque debe ser auditable. Cuando hay un incidente un humano tiene que ser capaz de verlo y entenderlo, ya sea para corregir el problema, o para escribir el post mortem.
Pero ¿cómo garantizamos que ese código sea de calidad? Bueno, tenemos herramientas anteriores a los LLM que nos permiten asegurar esa calidad.
Kimun es un destilado de algunas de esas herramientas; en este post explico cómo mide la calidad del código generado por la IA.
Los tests también son esenciales, pero ¿cómo sabes si esos tests están bien? Kalku es mi respuesta a esa pregunta, pero de eso hablaré en el próximo post.
Te presento a Kalku, un hechicero que se encarga de destrozar tus pruebas.
¿Y habrá formas de verificar las condiciones de carrera de un proceso concurrente de una manera formal? Sí la hay.
En los próximos artículos les voy a explicar cómo hacer todas estas cosas, pero si quieren aprenderlo de mejor manera les tengo una noticia.
Y acá es donde debes sospechar, porque te dije que no le creas a un tipo random en internet, y yo soy uno de esos y te quiero vender algo. Ups.
Voy a dictar un curso la próxima semana donde explicaré todo esto.
Son seis sesiones en línea, clases vía Zoom, que quedarán grabadas y disponibles para que las veas después.
En la primera sesión veremos cómo dirigir al agente. Aprenderemos sobre estilos de prompt y los métodos que han ido apareciendo para darle estructura al trabajo: spec-driven development, SPDD, BMAD y otros. Qué problema resuelve cada uno y cuándo el método pesa más que el modelo.
La segunda sesión se enfoca en subagentes y orquestación. Veremos cuándo conviene dividir el trabajo y cuándo un solo agente rinde más. Revisaremos patrones de orquestación y el costo real de coordinar.
Después vienen dos sesiones sobre cómo construir un harness, el andamiaje alrededor del agente: qué contexto recibe, qué herramientas tiene a mano y qué reglas lo gobiernan. Cómo lo enganchas en el ciclo de trabajo, creas comandos propios y lo conectas a tus servicios. Al final el harness deja de ser configuración y pasa a ser parte del repositorio.
Las sesiones finales se centran en la verificación: los tests como contrato. ¿Qué tipo de test sirve para qué? Y la pregunta incómoda: ¿tus tests atrapan algo? Y aprenderemos sobre métodos formales, calidad y evolución. Donde el test ya no alcanza: una introducción a Lean y parientes cercanos. Y cómo envejece un código escrito a gran velocidad.
Si te interesa aprender, te invito a inscribirte, el enlace es: https://ediaz.dev/cursos/agentes-avanzado/. Al llenar el formulario escribe el código LNDS-250 en la sección “¿Algo más que deba saber?” y tendrás el precio de promoción ($250,000 o USD 250).
Y si no te interesa el curso, igual te invito a suscribirte en mi newsletter, o esperar la próxima serie de artículos, porque hablaré de muchas cosas interesantes que he aprendido y que quiero compartir con ustedes.
Si quieres seguir esta discusión sin depender de tipos random en Twitter, suscríbete al boletín en newsletter.lnds.net. Y si lo que escribo te ha servido, considera apoyar este blog en Patreon: ahí publico contenido extra y quienes se suman participan en la selección de los temas que trato aquí.
Comentarios
comments powered by Disqus